登录社区云,与社区用户共同成长
邀请您加入社区
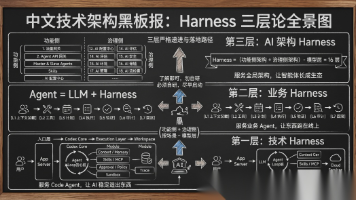
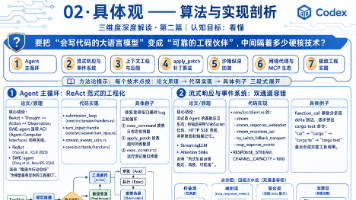
一个base模型本身跑不出Agent的全部能力。它是个受限于权重和当前上下文的顺序处理器:下一步决策只能用到权重和活跃上下文里暴露的状态。真正让它"动手"的,是包裹在外面的那层Harness:系统提示、工具注册、上下文管理与压缩、编排逻辑、验证规则、失败恢复。ReAct把它简化成"思考 - 行动"循环,Claude Code、Codex、OpenHands把它做成产品级系统。从ReAct到这些产品
桌面 App,进 Settings → General,点 “Import other agent setup”,它自动扫你本机的 Claude Code 配置。真正赚到的是那些把 Claude Code 玩出花的人——他们的 skills 和 MCP,才是大半年的心血。如果是你,你会因为"一键搬家"从 Claude Code 切到 Codex 试试,还是继续用熟的那个?现在配置能带走,剩下的,就
回顾 Codex 在前端组件生成上的核心价值鼓励读者动手尝试,从一个小组件开始附:常用提示词速查表。
2026 年,AI 编程助手已经从“代码补全工具”进化成了真正的开发协作伙伴。其中,OpenAI 推出的 Codex 系列凭借强大的任务理解与多步骤执行能力,成为很多开发者的主力工具。它不仅能帮你写代码,更能帮你想清楚要做什么、怎么做、以及如何验证做对了。相比过去的命令行或 IDE 插件形态,Codex 桌面版把项目托管、任务执行、终端操作、文件变更审查整合到了一个独立的图形界面中。
Hermes 在 Windows 上识别 npm 安装的 Codex 有 bug。
【例如:只有两年小时负荷数据,没有天气数据,目标是日前和实时预测】- 给出论文标题、作者、年份、链接、DOI或arXiv链接;- 研究对象:【论文、开源项目、工业方案、专利等】- 时间范围:【例如 2020~2026 年】- 优先使用论文原文、官方文档、开源项目主页;- 是否需要包含代码:【需要/不需要】- 区分论文中的事实、你的分析和推测;【我正在做什么项目,遇到了什么问题】- 应用领域:【例如
从 Codex Harness 拆到企业级 AI 架构,讲透技术 Harness、业务 Harness、AI 架构 Harness。
Codex 官网前端可抄吗」这个话题下已经有几十篇文章,我翻了一遍,绝大多数在讨论「抄袭的法律边界」,真正把页面扒开看的几乎没有。那就动手扒一次。技术栈——用什么框架、什么打包器、怎么组织资源工程细节——CSS 怎么管、字体怎么加载、图片什么策略性能——加载了多少东西页面本身的视觉设计不是最值得学的,真正有含金量的是它的中文字体加载策略和三层设计令牌体系。顺便还撞上了 Cloudflare,那段单
这篇文章从 AI Coding 中最常见的误区切入:真正决定 Cursor、Codex 工程表现的,往往不是 Prompt 写得多漂亮,而是 AI 是否拿到了正确的项目 Context(上下文)。文章系统拆解 Task、Repository、Architecture、Business、Runtime、Verification 六层上下文,并进一步讨论 Invariant(不变量)、Guardrai
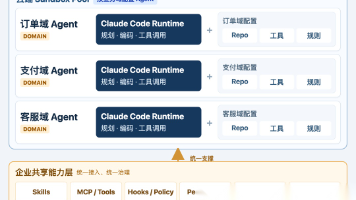
最近我一直在想一个问题:Claude Code、Codex 这类通用 Agent 都已经这么强了,我们还有必要从 0 到 1,自己造一个 Agent 吗?这个问题不是凭空来的。我们内部也在做研发 Agent(强烈安利,很有必要),按业务域部署在云端,主要用于研发答疑、问题排查和需求开发。
从"看见"到"看懂"再到"看透",三部曲走完了一条完整的认知升级之路:第一篇给了我们一张地图(架构),第二篇给了我们一台显微镜(算法),第三篇给了我们一副眼镜(哲学)。1. Codex 的全部代码,都在回答同一个时代问题:如何让不可预测的智能,承担可预测的工程责任。2. 它的答案不是"信任"而是"驯化"——用事件流让行为可回放,用四道闸让权限可收缩,用契约让系统可演进。3. 模型负责涌现,工程负责
Agent 主循环(第 1 章)是骨架——ReAct 范式给出了"思考与行动交织"的理论形状;流式系统(第 2 章)是血液——让骨架有了实时反应的脉搏;上下文工程(第 3 章)是代谢——长会话不至于"肥胖而死";(第 4 章)是双手——SWE-bench 的启示"补丁即交付物"塑造了这对精确的手;沙箱与代理(第 5、6 章)是免疫系统——四道闸把不可信的智能约束在可预测的轨道上;极致工程(第 7
它是什么:OpenAI 官方的本地编码 Agent,开源单仓库(monorepo),主体是约百个 crate 组成的 Rust workspace。它如何组织:入口层(cli/tui/app-server/exec/mcp-server)→ 内核层(core + protocol)→ 能力层(apply-patch/sandboxing/execpolicy/network-proxy/rollo
谦合益邦将持续深耕3D存算一体技术,用极致性能的芯片赋能更多应用场景,以芯为基,以存算为桥,迈向中国芯片产业的三维集成新时代。
本文深度解析PyTorch中两个核心张量维度操作算子:transpose与permute。transpose专为双维度交换设计,轻量化且内存安全;permute支持全维度自由重排,适合复杂变换场景。文章通过代码示例、特性对比和流程图,详细展示两者的使用差异与适用场景,并提供最佳实践与避坑指南,帮助开发者解决90%的维度不匹配问题。掌握这两个基础算子,是筑牢PyTorch开发地基的关键。
Moonshot AI(月之暗面)是 Kimi 大模型的开发者,以超长上下文处理能力著称,支持最高 200 万字的上下文窗口。
智谱 AI 是 GLM 系列大模型的开发者,由清华大学技术孵化。GLM-4 系列模型支持高达 1M(百万级)上下文窗口,中文理解能力出色。
本文系统介绍了树形数据结构及其应用,重点讲解了二叉树和堆的实现。首先阐述了树的基础概念、特性、表示方法、文件系统等实际应用场景。然后详细解析了二叉树的定义、分类(满二叉树和完全二叉树)及存储结构(顺序和链式)。接着深入讲解了堆的实现,包括大小根堆的定义、核心操作(创建/销毁、入堆/出堆)及调整算法(向上/向下调整)。最后探讨了堆的核心应用——堆排序和TOP-K问题,分析了算法的时间复杂度与优势。全
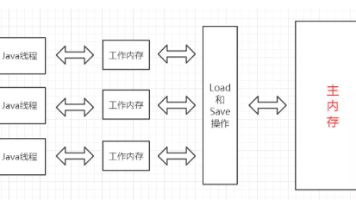
摘要:本文分析了多线程环境下的线程安全问题。通过一个count自增的示例,展示了线程不安全的原因:1)线程调度随机性;2)共享数据修改;3)操作缺乏原子性。解释了Java内存模型(JMM)中的主内存和工作内存概念,以及可见性问题。同时介绍了指令重排序对多线程的影响。最后给出了使用synchronized同步锁解决线程安全问题的方案,确保count变量在多线程环境下能正确累加到预期值10万。文章涵盖
元素地址 = 数组起始地址 + 下标 × 元素类型字节数(int 类型占 4 字节,所以。,编译器会自动计算数组长度,无需手动指定,且数组创建后直接填充好元素(没有默认值阶段)。中存储区域的唯一标识,本质是一个十六进制的内存地址(通过数组名间接持有)。(如 int=0、String=null),后续再通过下标手动给元素赋值。(2) 元素访问的底层逻辑(地址值 + 下标)(2) 增强 for 循环遍
呢,再讲一下:因为邻接表不像邻接矩阵那样顺序存储,邻接矩阵是有顺序的,而邻接表是链表,一个顶点如果连接着两个以上的顶点,第一个顶点可以是连接着的任何一个顶点,所以就有不同的邻接表,而邻接表不同,所遍历的序列自然也不同!BFS的实现是以队列为辅助!大家都知道,队列的特性就是先进先出,所以我们完全可以创建一个队列,将一层的顶点先入队,出队一个节点,就将出队节点所连接的其他未入队顶点全部入队,然后不断循
量化(Quantization):将模型参数从高精度(如 FP32)转换为低精度(如 INT8),减少存储和计算开销。数学表示为:$$ \text{量化}(x) = \text{round}\left(\frac{x}{\text{scale}}\right) + \text{zero_point} $$其中 $x$ 为原始值,$\text{scale}$ 和 $\text{zero_point}
DeepSeek 前几天发布了 V3.2 的正式版公告。标准版的DeepSeek - V3.2适用于日常场景,而DeepSeek - V3.2 - Speciale 则具备较强的指令跟随、数学证明和逻辑验证能力。
堆是满足以下两个条件的完全二叉树结构条件:必须是「完全二叉树」(层序遍历填满,最后一层节点从左到右连续排列,无空缺);顺序条件(堆序性):任意父节点与子节点满足固定的大小关系(分两种类型)。特性说明结构特性完全二叉树,可用数组高效存储,无需指针顺序特性仅约束父-子关系,兄弟节点无顺序要求最值特性大顶堆顶是最大值,小顶堆顶是最小值,取最值时间复杂度O(1)操作复杂度插入/删除堆顶:O(log n)(
本文提出了一种适用于CPU环境的数学推理模型Deepseek,通过参数压缩和精度调整降低内存需求,结合动态路由MoE层和多策略注意力机制优化计算效率。模型采用HeavyMathTokenizer处理数学表达式,构建包含Transformer、MoE、蒸馏损失等模块的轻量化架构,并通过15种可视化工具监控训练过程。实验显示,在500条数学题数据集上训练后,模型能处理简单方程和几何问题,但存在推理效果
范式1(经典控制理论)和范式2(强化学习)。范式1基于确定性模型,如PID控制器,确保基础稳定性;范式2利用数据驱动方法,如强化学习,优化复杂环境下的决策。二者互补:范式1适用于低风险、静态场景;范式2适配动态、不确定性高的任务。下面,我将逐步优化梳理核心内容。技术维度稳定悬停场景避障飞行场景轨迹跟踪场景感知配置:IMU+气压计+GPS<br>核心:实时姿态估计,误差控制在$<0.5^\circ$
一直以来,我都希望能拍一组日照金山的照片,向往那种巍峨雪山的寂寥与金光漫射的神圣,因缘际会一直未能如愿。看着朋友圈的AI整的手办图,咱也试试生成一个。
近日,快手正式发布全新推出的端到端多目标融合排序框架——EMER。该框架以其“会比较、自进化”的核心能力,重构了传统依赖人工经验公式的推荐模式,在快手主站App与极速版应用中实现了七日留存提升0.13%~0.2%、用户停留时长提升1.2%~1.4% 的显著效果,为行业推荐系统的智能化升级提供了可落地的解决方案。
本文是一份面向初学者的Linux系统入门教程,重点讲解CentOS 7的基础操作和核心概念。教程从操作系统基本概念入手,介绍了Linux文件系统、常用命令(如ls、pwd、cd、touch等)、路径定位(绝对路径与相对路径)以及实用技巧(如管道符|、通配符*、快捷键等)。内容采用"理论+实践"方式,通过对比Windows系统帮助理解,并包含大量操作示例。教程适合计算机专业学生、
想要学会c++11的各种新语法和特性?看这一篇文章就够了,万字详解!
评估AI模型性能需区分准确率、精确率、召回率和F1分数。准确率衡量整体正确率但易受样本不均衡影响;精确率关注预测正例的准确性,适用于FP代价高的场景;召回率关注真实正例的识别率,适用于FN代价高的场景;F1分数则平衡精确率和召回率,适用于两者都需兼顾的情况。根据业务需求选择合适的评估指标才能有效判断模型效果。
这篇文章通过小学考试比喻,生动解释了大模型强化学习中的GRPO算法。从单纯使用Reward的问题出发,逐步介绍了Critic提供"预期分数线"改善奖励机制、Clip操作防止更新过度、Reference Model防止极端策略等方法,最后详解了GRPO如何用"多次模拟成绩平均值"代替价值函数,减少计算负担同时保持训练稳定性。GRPO的创新在于省去了价值网络,让同一问题多条输出的平均分作为基线,既降低
收录大学专业的多种习题,不管是网课答案还是教材习题,都能在这里找到答案,而且还有四六级、考公、考研等备考资料,很是实用。它的搜题模式也是比较丰富的,支持文字搜题、拍照搜题、扫码搜书等搜题模式,轻松解决学习上的难题。